받아쓰기 오류 12,932개를 세어 봤습니다 — 가장 많이 놓치는 건 이미 아는 단어였어요
64개국 영어 학습자 325명이 받아쓴 14,039문장의 데이터입니다. 가장 많이 놓친 단어는 is, the, a, it, to였고, 실제 원어민 말소리에서는 오류의 절반 이상이 아예 들리지 않은 단어였습니다.
영어를 공부하는 사람이라면 누구나 이런 순간을 겪습니다. 영상을 보는데 절반 정도밖에 못 알아듣다가, 자막을 켜 보면 — 전부 아는 단어예요.
그럼 뭐가 문제였을까요? 어휘가 부족해서, 말이 빨라서, 억양 때문에… 다 그럴듯합니다. 저희는 추측 대신 직접 세어 볼 방법이 있었습니다.
Dictation Trainer는 모든 답을 단어별로 채점합니다. 원문의 각 단어는 맞게 들었거나, 놓침(그 자리에 아무것도 쓰지 않음), 잘못 들음(다른 단어를 씀), 철자 오류(단어는 맞았지만 철자가 틀림) 중 하나로 표시됩니다. 그래서 연습할 때마다 어떤 단어를, 어떻게 놓쳤는지에 대한 정확한 기록이 남습니다.
그 기록을 전부 합산해 봤습니다.
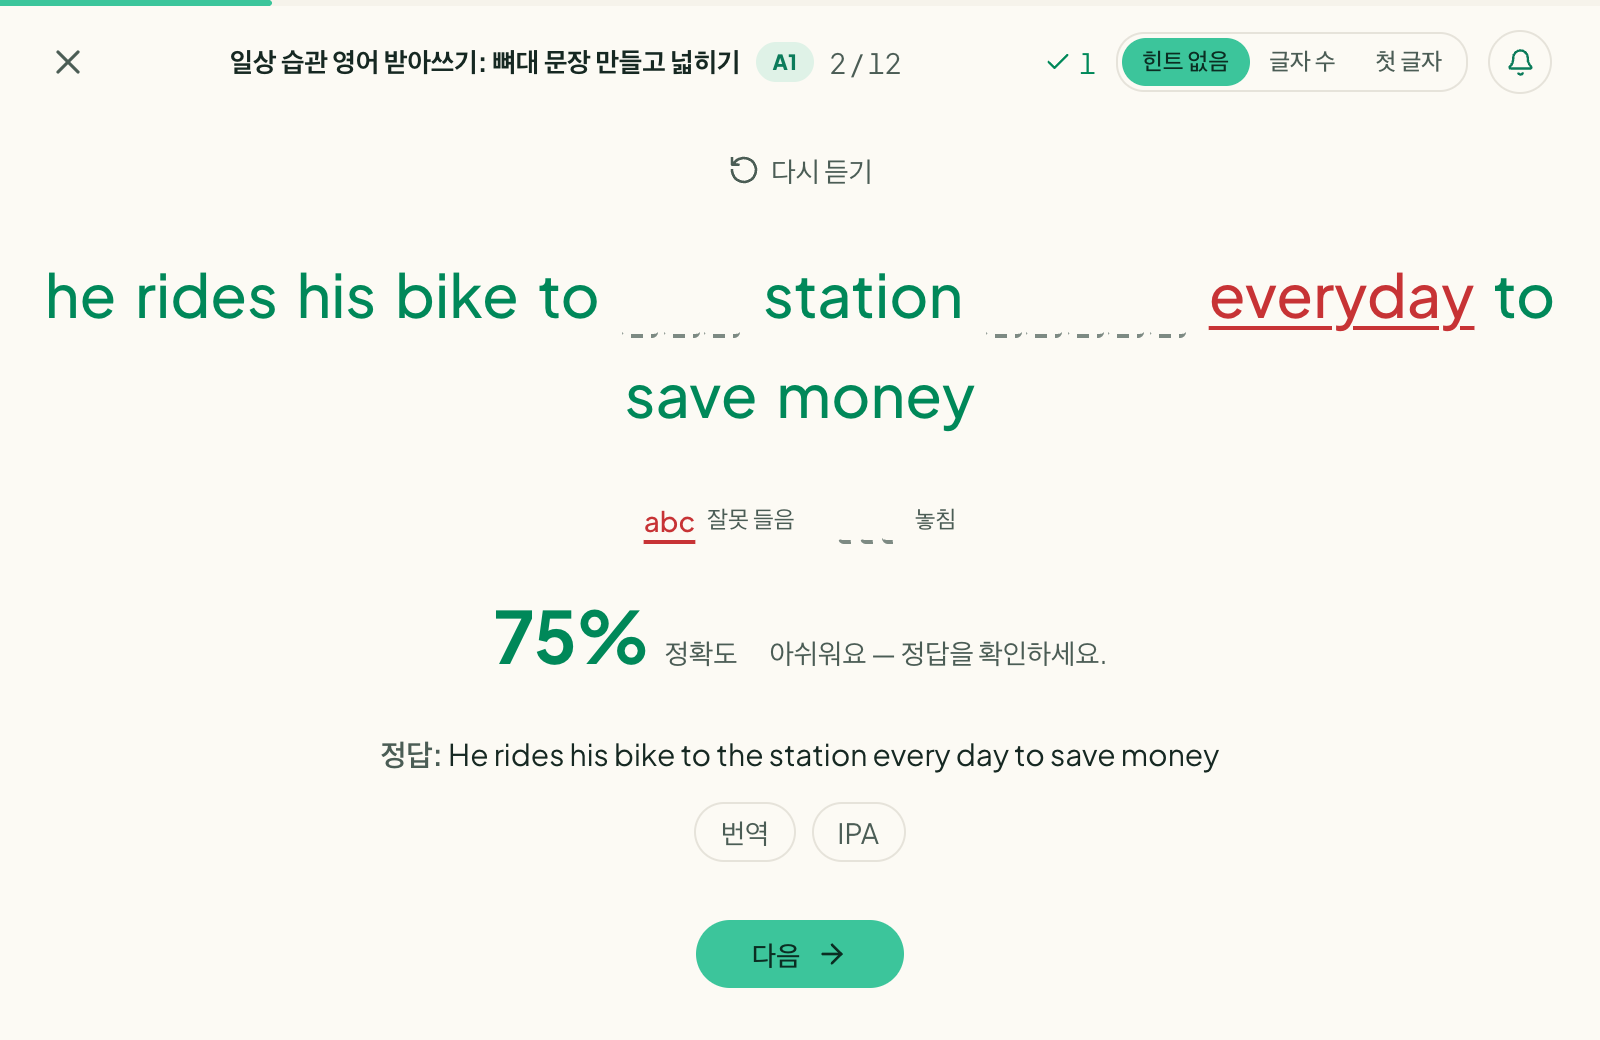
무엇을 셌나
- 64개국의 학습자 325명 (가장 많은 순서: 베트남, 미국, 태국, 한국)
- 14,039문장, 채점한 단어 90,584개, 2026년 7월~10월
- 오류 12,932개, 유형별로 보면:
| 오류 유형 | 횟수 | 비율 |
|---|---|---|
| 놓침 — 아무것도 쓰지 않음 | 5,312 | 41% |
| 철자 오류 — 단어는 맞고 철자가 틀림 | 4,348 | 34% |
| 잘못 들음 — 다른 단어를 씀 | 3,272 | 25% |
숫자 단어(one, seven, twenty…)는 제외했습니다. seven을 "7"로 입력한 사람은 사실 완벽하게 들은 거니까요. 전체 집계 방법과 한계는 글 마지막에 정리했습니다.
발견 1: 가장 많이 놓치는 건 가장 짧은 단어
오류가 가장 많았던 단어 10개입니다.
| 순위 | 단어 | 오류 횟수 |
|---|---|---|
| 1 | is | 509 |
| 2 | the | 454 |
| 3 | a | 415 |
| 4 | it | 329 |
| 5 | to | 260 |
| 6 | in | 210 |
| 7 | you | 200 |
| 8 | I | 199 |
| 9 | and | 171 |
| 10 | are | 160 |
사전을 찾아볼 만한 단어는 하나도 없습니다.
범위를 넓혀도 패턴은 같습니다. 문장에 나온 가장 흔한 단어 100개가 학습자가 들은 전체 단어의 65%를 차지했고, **전체 오류의 51%**를 차지했습니다. 듣기에서 생기는 실수의 절반이 초보자도 이미 "아는" 단어에서 일어나는 셈입니다.
이게 바로 "자막을 켜면 다 아는 단어"의 정체입니다. 단어를 아는 건 맞아요. 다만 글자로 쓰인 모습을 아는 거죠. 실제 말에서 is, the, a, to는 철자대로 발음되는 경우가 드뭅니다. 빠르고 약하게 줄어든 소리로 바뀌어 앞뒤 단어에 달라붙어요. 귀는 사전 발음의 단어를 기다리는데, 그 모습으로는 끝내 나타나지 않는 겁니다. (단어는 아는데 왜 안 들릴까에서 원인이 되는 세 가지 소리 변화를 자세히 설명했습니다.)
발견 2: 짧은 단어는 사라지고, 긴 단어는 철자가 틀린다
짧은 단어와 긴 단어는 틀리는 방식이 완전히 다릅니다.
| 단어 길이 | 오류율 | 가장 흔한 오류 |
|---|---|---|
| 1–4글자 | 11–13% | 놓침 (약 절반) |
| 5–6글자 | 15–18% | 철자 오류가 많아지기 시작 |
| 7글자 | 22% | 철자 오류 |
| 8글자 이상 | 30% | 철자 오류 (46%) |
긴 단어는 틀릴 확률이 더 높지만, 틀렸을 때 학습자는 대개 듣긴 들었고 철자를 못 쓴 겁니다. 짧은 단어는 덜 자주 틀리지만, 틀렸다 하면 대개 통째로 사라집니다. 세 글자 이하 단어의 오류 중 54%는 단어가 있어야 할 자리가 비어 있었어요.
게다가 짧은 단어는 어디에나 나오기 때문에 오류의 총량은 훨씬 많습니다. 서로 다른 두 문제이니, 해법도 다릅니다.
- 긴 단어는 철자와 어휘의 문제입니다. 단어장과 읽기가 도움이 됩니다.
- 짧은 단어는 듣기의 문제입니다. 아무리 읽어도 해결되지 않아요. 이미 읽을 줄 아니까요.
발견 3: 실제 말소리에서는 오류의 절반 이상이 '아예 안 들린' 단어
저희 문장 대부분은 짧고 또박또박 읽은 레슨 문장입니다. 하지만 학습자들은 인터뷰, 팟캐스트, 브이로그 같은 자신의 유튜브 영상을 가져와 문장 단위로 받아쓰기도 합니다. 둘을 비교하면 차이가 분명합니다.
| 레슨 문장 | 실제 유튜브 말소리 | |
|---|---|---|
| 채점한 단어 | 67,512 | 23,072 |
| 오류율 | 10.7% | 24.8% |
| 오류 중 놓침 비율 | 32% | 52% |
자연스러운 말소리에서는 오류율이 두 배 넘게 뛰고, 오류의 절반 이상이 단어가 그냥 사라진 경우였습니다. 유튜브 영상에서 가장 많이 놓친 단어는? the, a, I, to, is, and, you, it. 앞의 목록과 똑같고, 더 심해졌을 뿐입니다.
(공정하게 덧붙이면, 사람들이 가져오는 영상은 전반적으로 더 어렵기도 해서 오류율 상승이 전부 "자연스러운 말소리" 때문만은 아닙니다. 다만 오류가 '놓침' 쪽으로 쏠리는 현상은, 짧은 단어가 한층 더 약하게 발음될 때 정확히 예상되는 결과입니다.)
발견 4: 계속 반복되는 혼동
'잘못 들음' — 학습자가 다른 단어를 쓴 경우 — 은 몇 가지 패턴에 몰려 있었습니다.
| 원문 | 학습자가 쓴 것 | 횟수 |
|---|---|---|
| a ↔ the | 다른 쪽 관사 | 150 |
| every day | everyday | 37 |
| let us | let's | 31 |
| too | to | 28 |
| you are | your | 19 |
| any more | anymore | 18 |
| here | hear | 13 |
| what is | what's | 12 |
| know | no | 8 |
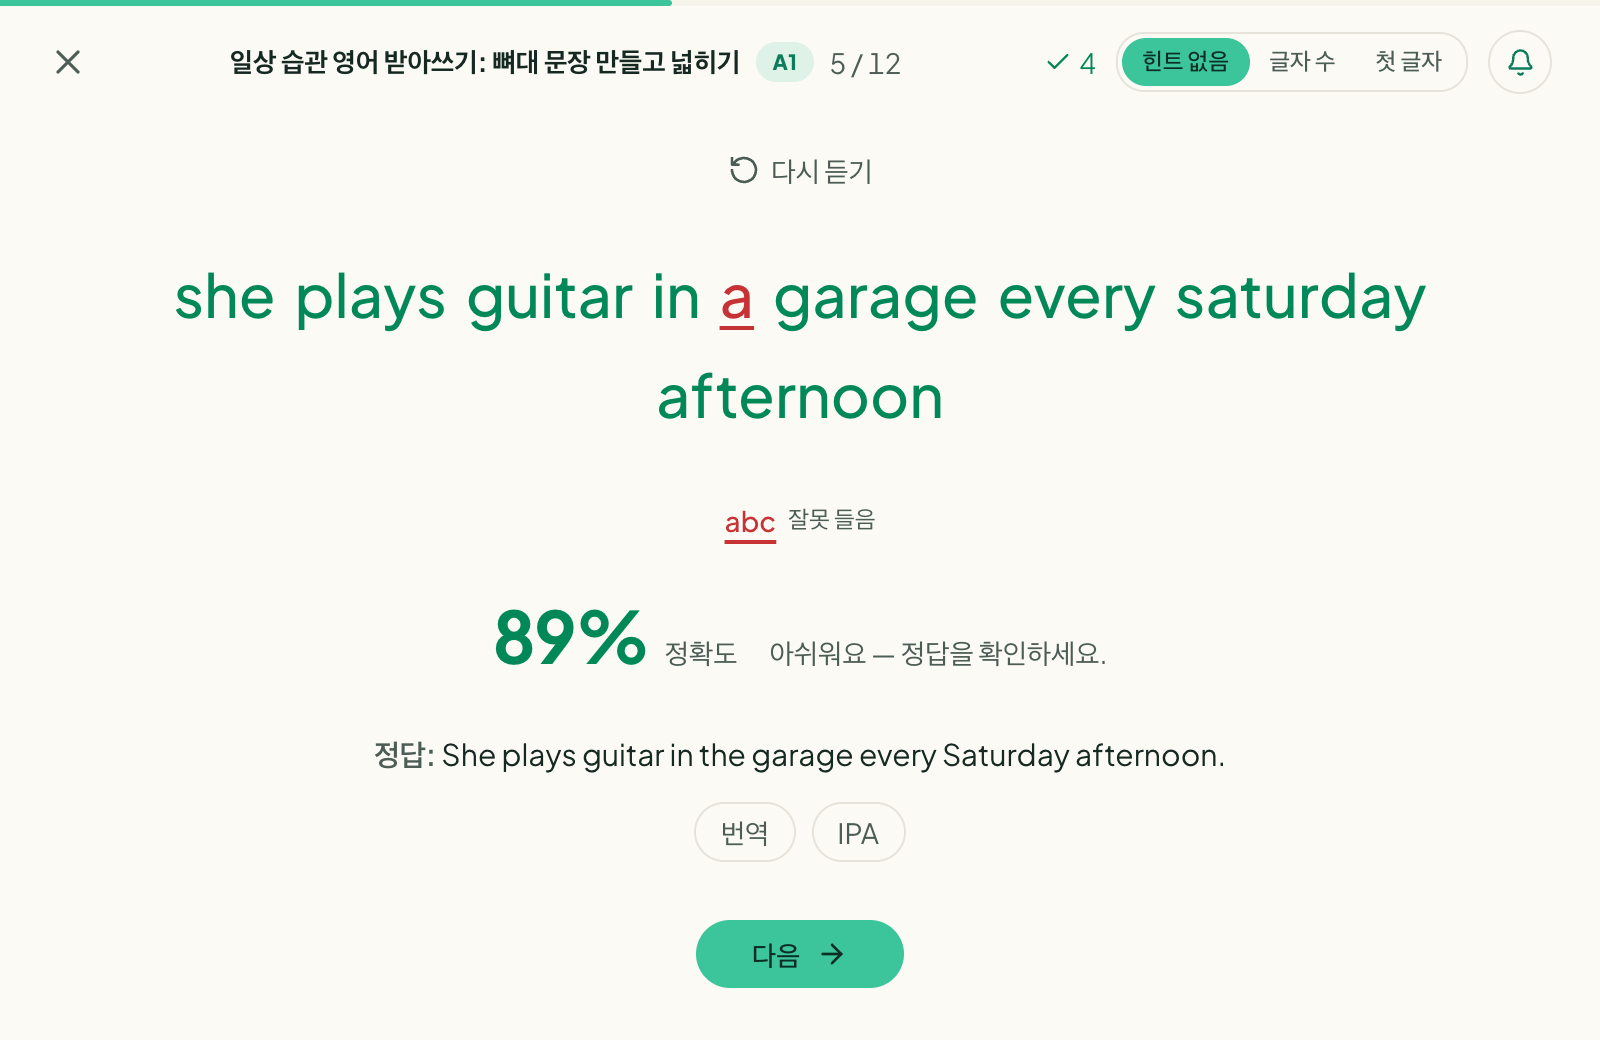
눈에 띄는 점이 몇 가지 있습니다.
- 귀에는 a와 the가 거의 같습니다. 보통 속도에서는 둘 다 짧고 약한 음절로 줄어 서로 헷갈리기 쉽고, 학습자는 문법적으로 자연스러워 보이는 쪽을 채워 넣습니다. 전체 데이터에서 가장 흔한 혼동이에요.
- 원문에 없는 축약형을 듣습니다. let us는 let's로, what is는 what's로, you are는 your로 (you're와 소리가 같으니까요). 빠른 말은 줄어든다는 걸 뇌가 배웠고, 그걸 과하게 적용하는 거죠.
- 동음이의어는 귀가 아니라 맥락의 문제입니다. too/to, here/hear, know/no는 소리가 똑같습니다. 맞히려면 문장을 이해해야 하기 때문에, 이런 오류는 학습 초반이 아니라 후반까지 남는 경향이 있습니다.
그럼 어떻게 연습할까
1. 짧은 단어를 의식적으로 세세요. 문장을 다시 들을 때 뜻은 잠시 잊고 단어 수를 세 보세요. 원문이 열한 단어인데 아홉 개만 들렸다면, 빠진 두 개는 거의 틀림없이 위 목록에 있습니다. 받아쓰기는 구조적으로 이걸 강제하고, 그래서 "그냥 많이 듣기"보다 효과가 있습니다. (영어 받아쓰기 15분 연습법에 구체적인 순서를 정리했습니다.)
2. 짧은 단어가 '보이는' 모습이 아니라 '들리는' 모습을 익히세요. to는 보통 가벼운 "터", and는 "ㄴ" 소리만 남는 경우가 많고, are는 앞 단어에 붙어 버리곤 합니다. 약하게 줄어든 형태를 알면 들리기 시작합니다 — 그리고 그 목록은 길지 않아요.
3. 긴 단어의 실수는 듣기가 아니라 철자 문제로 다루세요. 들었는데 철자를 못 썼다면, 필요한 건 단어장이지 더 많은 음성이 아닙니다.
4. 레슨이 쉬워지면 실제 말소리로 넘어가세요. 대략적인 기준으로, 레슨 문장에서 90% 정도가 나오면 귀가 다음 단계로 갈 준비가 된 겁니다. 짧은 단어가 가장 어려워지는 곳이 바로 실제 말소리이고, 여러분이 정말 알아듣고 싶은 것도 그 영어입니다. (내 수준에 맞는 유튜브 영상 고르는 법)
집계 방법과 한계
- 학습자별로 각 문장의 가장 최근 답을 집계했습니다. 다시 시도한 사람은 대개 더 나아진 나중 답이 남기 때문에, 오차가 있다면 첫 번째로 들었을 때의 놓침을 과소평가하는 쪽입니다.
- 숫자 단어는 제외했고, 원문에 없는데 학습자가 추가로 쓴 단어(663건)도 제외했습니다.
- 레슨 문장은 대부분 짧고 A1–B1 수준이며, 학습자는 성인 독학자가 많고 단일 국가로는 베트남이 가장 많습니다. 이 데이터는 저희 학습자를 설명하는 것이지, 모든 영어 학습자를 대표하지는 않습니다.
- 통제된 실험이 아니라 사용 데이터 분석입니다. 다른 학습자, 다른 자료라면 구체적인 비율은 달라질 수 있습니다.
직접 확인해 보세요
내가 어떤 단어를 놓치는지 알아내는 가장 빠른 방법은 몇 문장을 받아써 보고 무엇이 사라졌는지 보는 겁니다. 가입 없이 바로 무료 레슨을 시작할 수도 있고, 유튜브 영상을 받아쓰기 레슨으로 만들어 문장 단위로 연습할 수도 있습니다. 모든 답은 위 예시처럼 단어별로 채점됩니다.